Memoria escasa y IA en casa: el choque entre concentrar cómputo en la nube y procesar en el equipo
El CEO de OpenAI cuestiona que los modelos se ejecuten en computadoras personales mientras la DRAM encarece. Los defensores de la IA local responden con la privacidad.
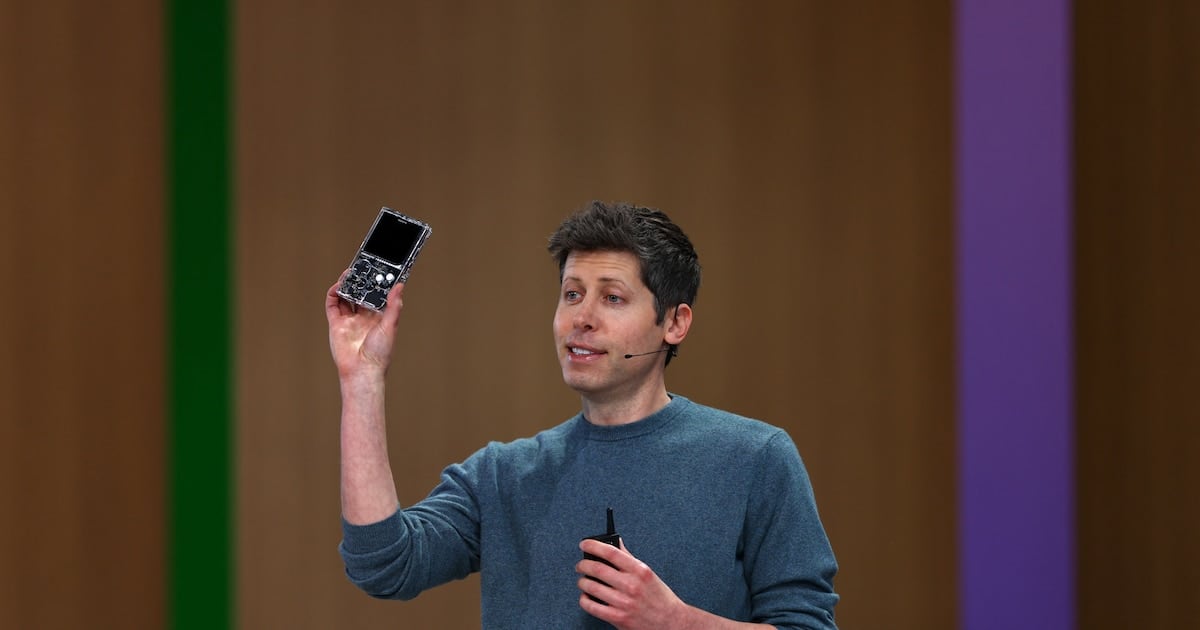
El director ejecutivo de OpenAI, Sam Altman, sostuvo que correr modelos de inteligencia artificial en computadoras domésticas es una mala asignación de memoria DRAM, un componente cuyo precio subió entre un 90% y un 95% en el primer trimestre de 2026. Según su planteo, concentrar ese recurso en centros de datos de uso continuo daría mayor rendimiento global.
Qué es la inferencia local
La inferencia local es ejecutar un modelo de inteligencia artificial directamente en el dispositivo del usuario, sin enviar las consultas a servidores remotos. Para entenderlo, la memoria DRAM funciona como una mesa de trabajo: ahí se apoyan los datos mientras la computadora los procesa. Cuanto más grande es el modelo, más espacio de mesa necesita. La práctica creció junto con la disponibilidad de modelos de código abierto que pueden instalarse en equipos de gama media o alta.
“La inferencia local es una terrible asignación de recursos escasos. Mucha gente quiere inferencia local y, de algún modo, asume que el problema está resuelto porque tenemos modelos de código abierto que podemos ejecutar en nuestros ordenadores.”Sam Altman, director ejecutivo de OpenAI
La lógica de la concentración
El argumento de Altman parte de una comparación de eficiencia. Un centro de datos puede aprovechar la misma memoria las 24 horas, mientras que una computadora personal la usa una fracción mínima del día. Altman cifró la subutilización del equipo personal en un 5% del tiempo de uso efectivo. En un contexto de oferta restringida, sostuvo, repartir ese recurso entre millones de equipos individuales reduce el rendimiento del sistema en su conjunto.
Los datos del mercado respaldan en parte ese diagnóstico. Según TrendForce, los precios de la DRAM aumentaron entre un 90% y un 95% durante el primer trimestre de 2026. Fabricantes como Micron y SK Hynix no logran escalar la producción al ritmo que exigen los grandes operadores de centros de datos dedicados a IA. Algunas compañías comenzaron a redirigir capacidad hacia memoria HBM, de alto rendimiento, aunque ampliar plantas especializadas demora más de un trimestre.
Quienes defienden la IA local responden con el argumento de la privacidad: procesar los datos en el propio equipo evita enviarlos a servidores externos. La discusión queda así planteada entre la eficiencia de la infraestructura centralizada y el control que el usuario conserva sobre su información.
Comentarios
0Todavía no hay comentarios. Sé el primero.
Seguí leyendo
GPT‑5 podría llegar en agosto de 2025: esto es lo que se sabe hasta ahora
¿Llega la tercera tilde azul a WhatsApp? Su función despertará polémica
WhatsApp Dice Adiós a Algunos Celulares a Partir del 15 de Abril de 2025